جهش گوگل با Gemini 3.8؛ معرفی و بررسی کامل (نسخههای Flash، Live و Omni 1.1)
بهروزرسانی ۲ سپتامبر ۲۰۲۶: Gemini 3.8 Flash
گوگل در 2 September، مدل Gemini 3.8 را معرفی کرد و گفت: «مدلی که بهترین عملکرد را در زمینه استدلال و کدنویسی ارائه میدهد و همان سرعت و هزینه پایینِ نسخه 3.7 را حفظ کرده است.»
نسخههای Gemini 3.8
Gemini 3.8 در دو نسخه عرضه شده است که هرکدام قابلیتها و امکانات خاصی دارند.
Gemini 3.8 Flash
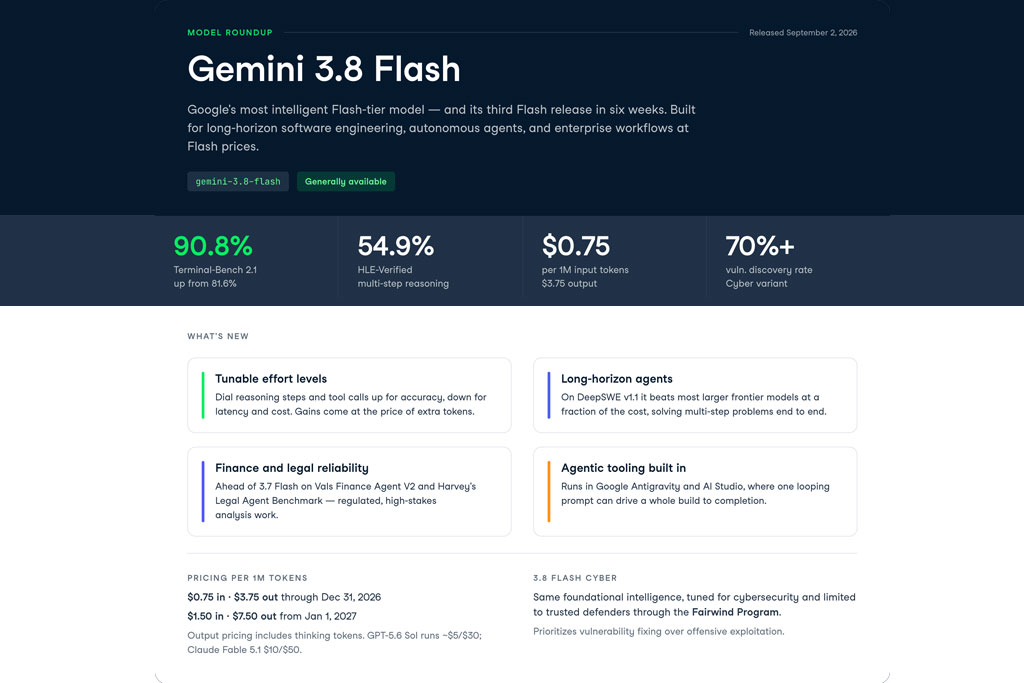
هوشمندترین مدل کارآمد گوگل که پیشرفتهای قابل توجهی نسبت به 3.7 Flash در مهندسی نرمافزار، وظایف عاملمحور و استدلال چند مرحلهای و حیاتی در حوزههای تخصصی ارائه میدهد. این مدل با همان قیمت اولیه 3.7 Flash، یعنی 0.75 دلار به ازای هر میلیون توکن ورودی و 3.75 دلار به ازای هر میلیون توکن خروجی در دسترس است.
Gemini 3.8 Flash Cyber
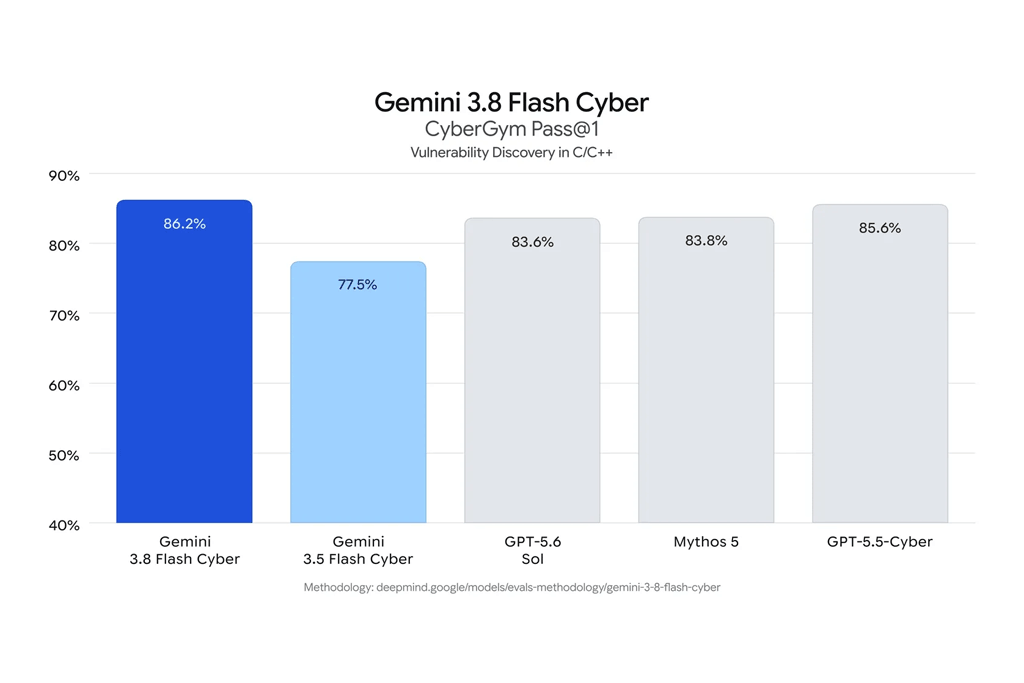
درحالحاضر توانمندترین مدل Gemini است که دقت و تخصص بالایی در امنیت سایبری، تشخیص آسیبپذیری و وصلهگذاری خودکار (Automated Patching) دارد. این مدل فعلا فقط از طریق برنامه جدید Fairwind گوگل در دسترس کاربران منتخب است.
جدول مشخصات فنی هوش مصنوعی Gemini 3.8 Flash
| قابلیت | جزئیات |
| ورودی | متن، تصویر، صوت، ویدیو، PDF |
| خروجی | متن |
| حداکثر پنجره Context | ۱٬۰۴۸٬۵۷۶ توکن |
| حداکثر خروجی | ۶۵٬۵۳۶ توکن |
| حالت تفکر عمیق (Thinking) | Low، Medium، High |
| اجرای کد | ✅ |
| Function Calling | ✅ |
| Google Search Grounding | ✅ |
| Google Maps Grounding | ✅ |
| Batch API | ✅ |
| Computer Use | آزمایشی |
| Live API | ❌ |
| تولید تصویر | ❌ |
| تولید صدا | ❌ |
مقایسه Gemini 3.8 Flash با هوش مصنوعیهای دیگر
گوگل به این مدل جدیدش افتخار میکند؛ بهقدری که دست به مقایسه با مدل قبلی – یعنی Gemini 3.7 Flash – زده است. تصویری که در پایین میبینید در صفحه رسمی معرفی این مدل منتشر شده که مقایسه Gemini 3.8 Flash، Gemini 3.7 Flash و هوش مصنوعیهای دیگر را یکجا انجام داده است.
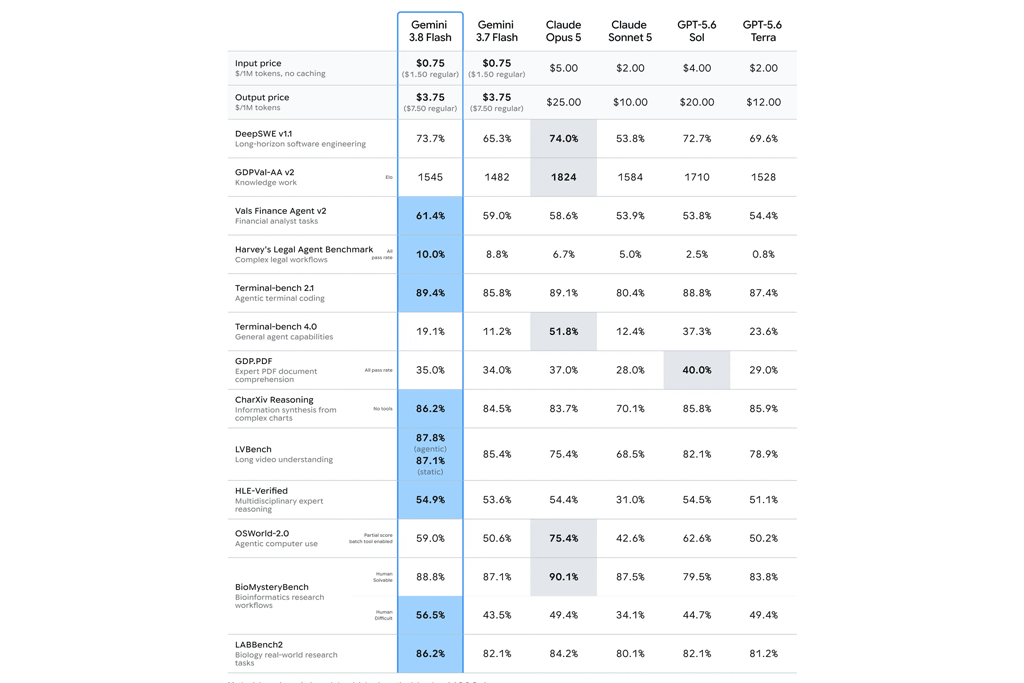
جدول مقایسه تخصصی Gemini 3.8 Flash و Gemini 3.7 Flash
| معیار | 3.8 Flash | 3.7 Flash |
| Terminal-bench 2.1 | 90.8% | 81.6% |
| SWE-Bench Pro | 61.6% | 60.4% |
| SWE-Atlas | 51.9% | 48.0% |
| τ³-bench Banking | 38.1% | 30.9% |
| CharXiv (Multimodal) | 86.2% | 84.5% |
| GDP.pdf | 35.0% | 34.0% |
| Humanity’s Last Exam (HLE) | 45.4% | 45.7% |
تحلیل بنچمارکهای هوش مصنوعی Gemini 3.8 Flash
بعضی از معیارهای بنچمارکها خیلی مهم هستند و پیشرفت و افزایش توانایی مدلها را نشان میدهند. ما در ادامه، این معیارها را بررسی کرده و تحلیلشان را توضیح میدهیم.
مهندسی نرمافزار
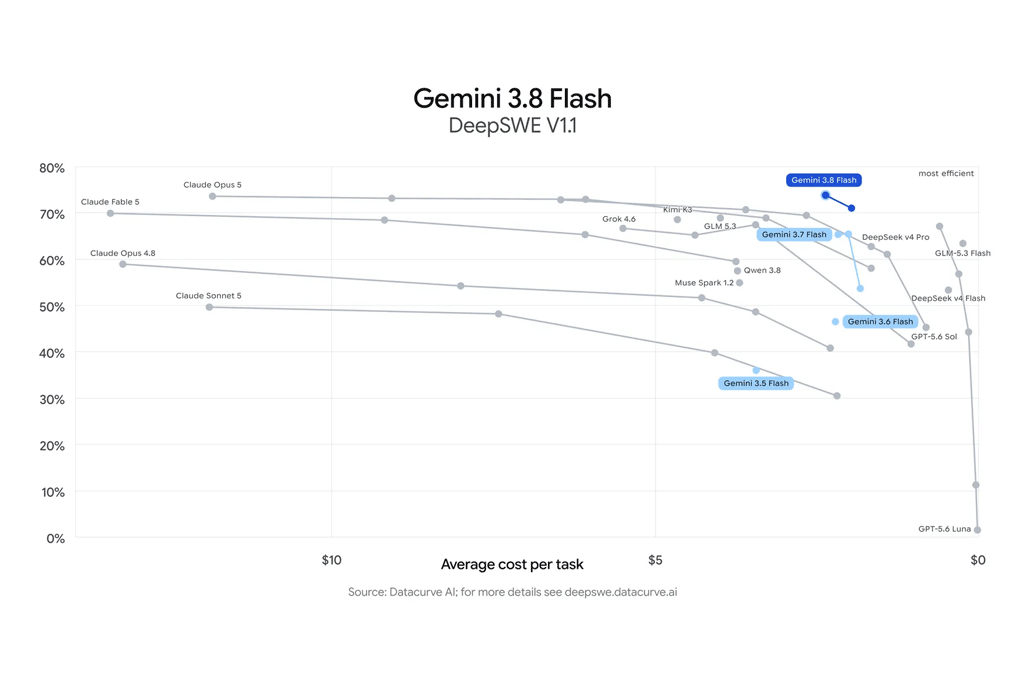
هوش مصنوعی Gemini 3.8 Flash در معیار DeepSWE Version 1.1 (مهندسی نرمافزار Long-Horizon)، توانست قوی ظاهر شود. در این آزمون، حل خودکار مسائل پیچیده مهندسی از ابتدا تا انتها ملاک اصلی موفقیت مدل است که Gemini 3.8 Flash توانست تا ۷۳.۷٪ موفق شود.
مدیریت استدلال در زمینههای پیچیده
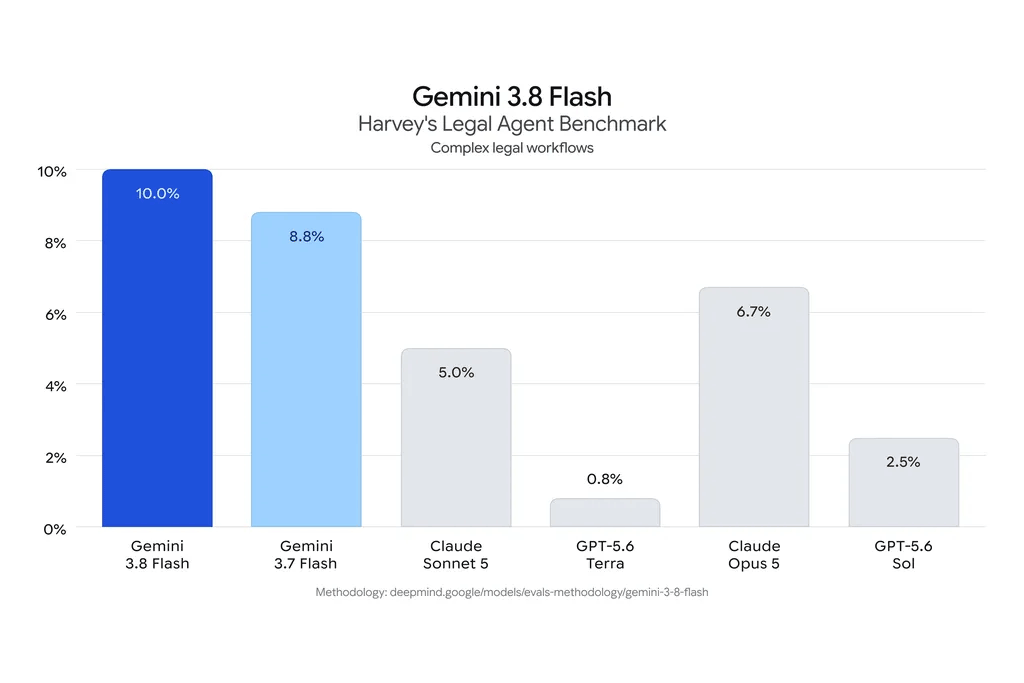
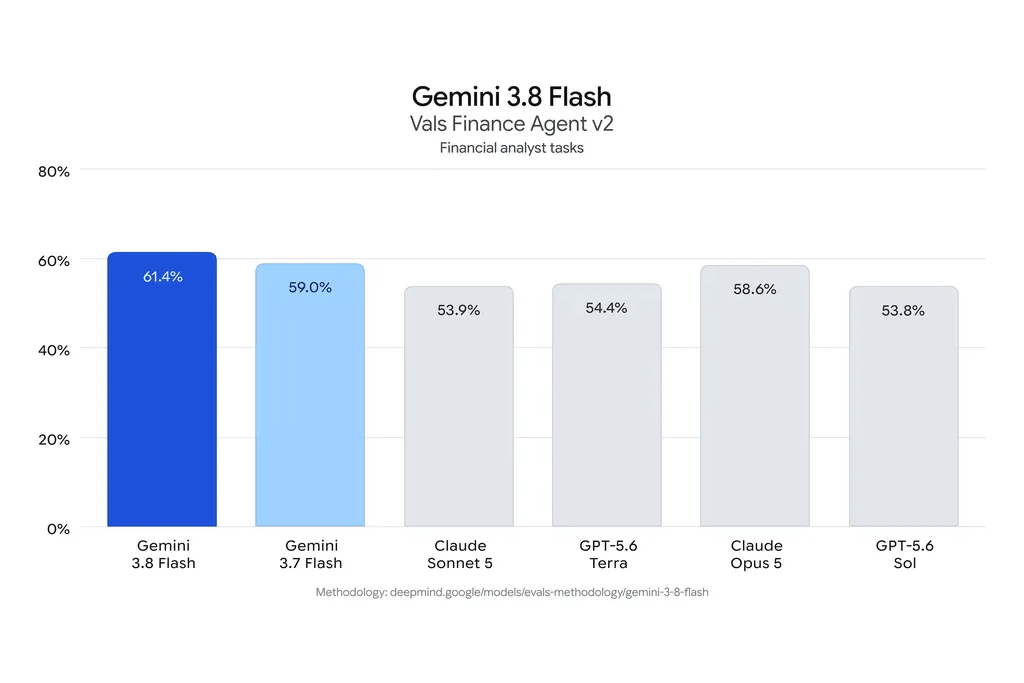
در زمینههای کمی و حرفهای که نیاز به تجزیهوتحلیل و گزارشدهی پیشرفته دارند، مدل ۳.۸ فلش در معیارهایی مانند Vals Finance Agent V2 و Harvey’s Legal Agent Benchmark از مدل ۳.۷ فلش و سایر مدلهای مرزی پیشی گرفت.
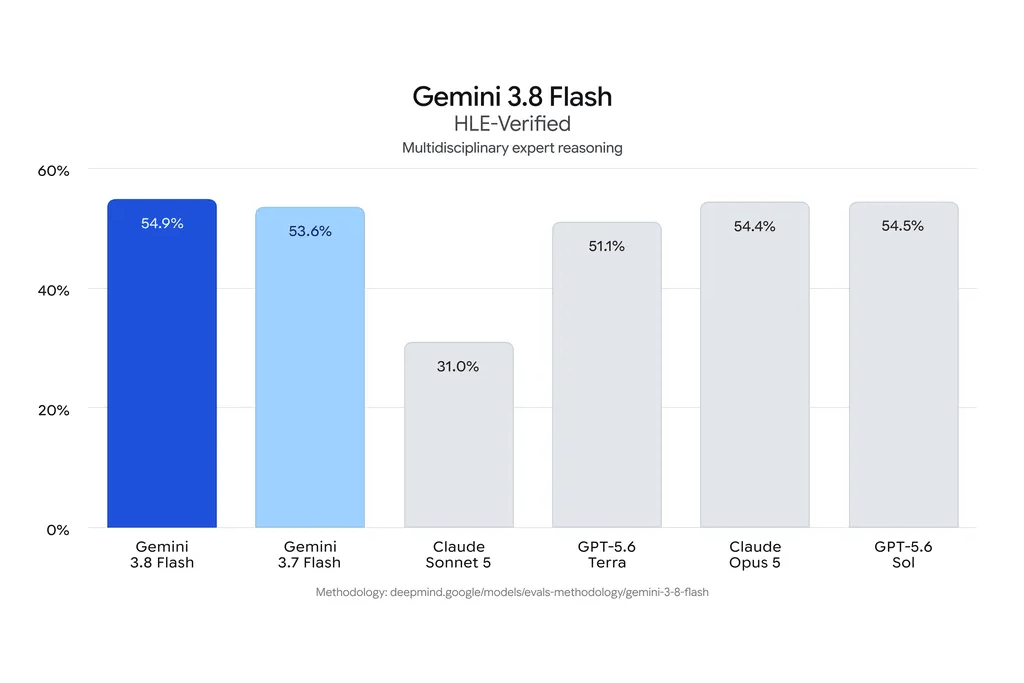
علاوه بر این، مدل ۳.۸ فلش در آزمون HLE-Verified به امتیاز ۵۴.۹٪ دست یافت که نشاندهنده توانایی آن در مدیریت استدلال چند مرحلهای در حوزههای STEM، علوم انسانی و حرفهای است.
به گردش کاری فکر کنید که در آن یک عامل مجموعهای از پروندههای سهماهه را میخواند و خلاصهای از وضعیت آن را میسازد. سپس همان خلاصه را با قوانین و شرایط سازمان تطبیق میدهد.
ویژگیهای جدید Gemini 3.8 Flash
هوش مصنوعی جمنای نسخه ۳.۸ فلش با چند ویژگی جدید ارائه شده است که در مدل قبلی وجود نداشت.
تنظیم سطوح Effort
شما میتوانید بسته به نیازتان نسبت به دقت یا هزینه، حالت Effort این هوش مصنوعی را کم یا زیاد کنید. در سطوح Effort بالاتر، فلش ۳.۸ مراحل استدلال بیشتری را اجرا میکند و ابزارها را مکررا فراخوانی میکند. در سطوح تلاش پایینتر، سربار توکن را برای کارهای حساس به تاخیر یا محدود به محاسبات به حداقل میرساند.
عاملهای خودمختار با توان اجرای کارهای طولانی
فلش Gemini 3.8 برای اجرای عاملهایی ساخته شده است که مشکلات چندمرحلهای نرمافزارها را حل میکنند؛ بدون اینکه نیاز به مداخله یا نیروی انسانی باشد.
ادغام سریع با ابزارهای عاملمحور در Antigravity و AI Studio
Gemini 3.8 Flash در ابزارهای دیگر گوگل ازجمله Google Antigravity و Google AI Studio اجرا میشود.
خودِ گوگل در اینباره گفت: «یک نسخه کاملا قابلپخش به سبک DOS را تصور کنید که مثل نقشههای گوگل بههمپیوسته است.
تصور کنید یک پرامپت بهشکل زیر نوشتید:
«یک داشبورد تعاملی بساز که این CSV را دریافت کند، سه نوع نمودار را ترسیم کند و به من اجازه دهد تا دادهها را براساس منطقه فیلتر کنم.»
در این حالت، حلقه عاملمحور جمنای ۳.۸ فلش تا زمان اتمام کار، تکرار میشود.
بهترین کاربردهای مدل Gemini 3.8 Flash
- تحلیل و Refactoring پروژههای بزرگ برنامهنویسی
- ساخت عاملهایی که چند ابزار و API را پشتسرهم اجرا میکنند
- تحلیل همزمان متن، تصویر، ویدیو و صوت
- خلاصهسازی مجموعه بزرگ اسناد یا PDFها
- تولید پاسخهای Markdown برای استفاده در نرمافزارها
- پردازش داده و گردشکارهای سازمانی
- اتوماسیون وظایف مرورگر و رابط کاربری (با Computer Use)
نگاه واقعی به عملکرد Gemini 3.8 Flash
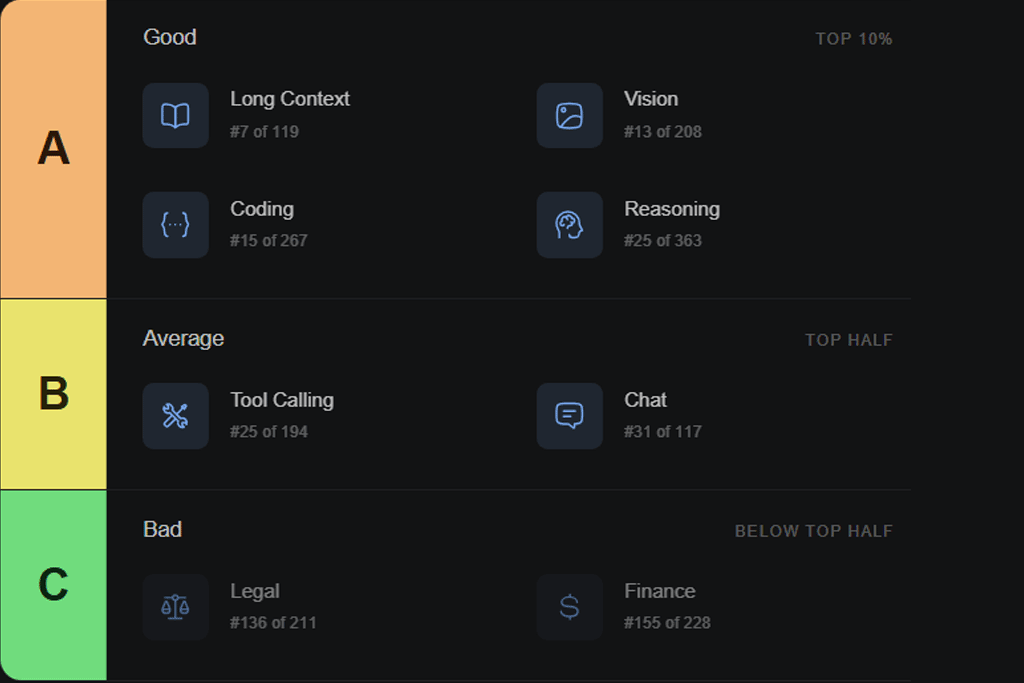
در وبسایت LLM Stats، تحلیل و بررسی عمیقی روی عملکرد مدل 3.8 Flash شده است که در قالب یک جدول و متشکل از سه رتبه آمده است:
بهروزرسانی ۱۵ سپتامبر ۲۰۲۶: Gemini 3.8 Live
گوگل با معرفی Gemini 3.8 Live و Gemini 3.8 Live Extended Thinking، توانست قدرت جدیدی را به رخ شرکتهای سیلیکونولی بکشد: چون این دو مدل همزمان با فکر کردن و پاسخ دادن، با شما حرف میزنند.
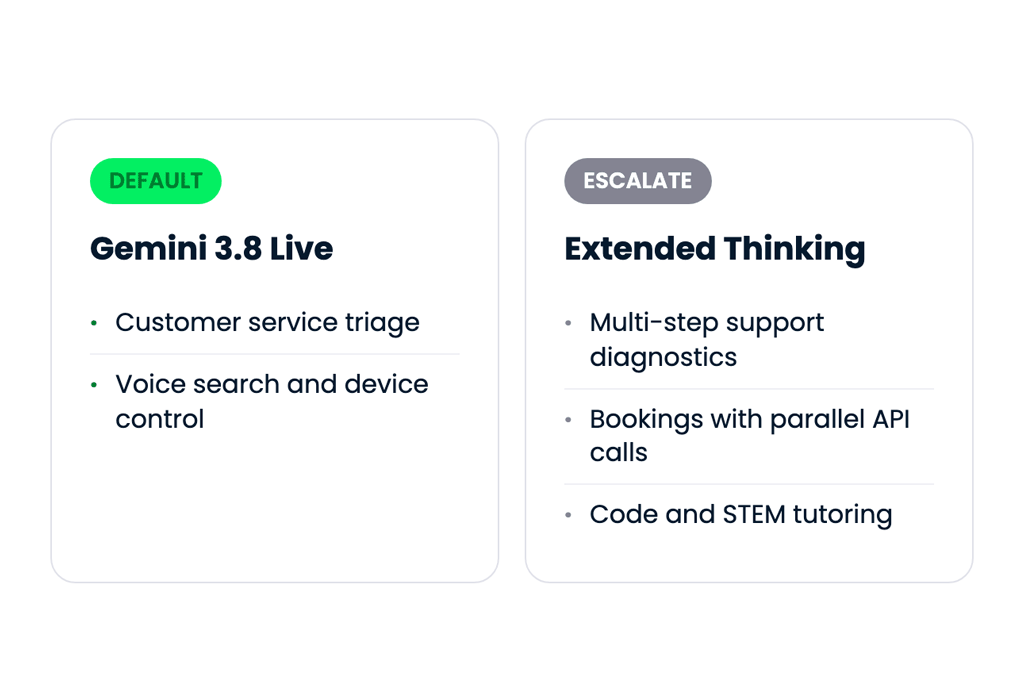
اگر بخواهیم کاربرد آنها را در دنیای واقعی بیشتر توضیح دهیم، باید بگوییم که هردو سیستمهای پیشرفته با تمرکز روی مکالمه صوتی هستند و دیگر کاربر محدود به چت نیست.
هم Gemini 3.7 Live و هم Gemini 3.8 Live Extended Thinking از طریق API Gemini Live و WebSocket اجرا میشوند. هردو صدا، ویدیو، تصاویر و متن را بهعنوان ورودی میگیرند و جواب را در قالب صدا ارائه میدهند.
مدل Gemini 3.8 Live
هدف طراحی و ساخت این مدل، مقیاسپذیری و بهرهوری هزینه است. گوگل در توصیف Gemini 3.8 Live میگوید که هوشمندی این مدل در کنار قابلیت مکالمه قرار گرفته است. به عبارت دیگر، Gemini 3.8 Live به کاربر اجازه میدهد تا با گفتوگوی لحظهای، با هوش مصنوعی جمنای صحبت کند و این ابزار همچنان درک بصری داشته باشد و آن را با مکالمه ترکیب کند.
مدل Gemini 3.8 Live Extended Thinking
این مدل برای وظایفی که پیچیدگی بالایی دارند طراحی شده است. علاوه بر این، هوش و استدلال این مدل بیشتر از Live است و میتواند فرآیندهای سخت چندمرحلهای را درک و حل کند.
ویژگیهای مدل Gemini 3.8 Live
در مدل Gemini 3.8 Live همزمان استدلال و صحبت کردن رخ میدهد و در دو ویژگی زیر متمایز است.
تغییرات پروتکل و تعامل زنده
اگر کاربر عباراتی مثل «اجازه بده بررسی کنم» را بگوید، مدل پردازش را تا لحظه ادامه مکالمه متوقف میکند. در این زمان، مدل Live با کاربر صحبت میکند و او را در جریان فرآیندها میگذارد.
ورودی بصری، دقت کد و چندزبان
این نسخه مکالمه صوتی را با ورودیهای بصری یکی میکند تا بتواند هم به آنچه کاربر میبیند و هم به آنچه میگوید پاسخ دهد. البته ارسال همزمان صدا و ویدیو هزینه و بودجه Context را بالا میبرد. در کنار این محدودیت، فعلا هر چت صوتی-تصویری به ۲ دقیقه محدود است (در مقابل ۱۵ دقیقه برای صوت).
جابهجایی بین زبانها در اواسط مکالمه
Gemini 3.8 Live در طول مکالمه، ۹۷ زبان پشتیبانیشده را تشخیص داده و بین آنها جابهجا میشود. گوگل نام این قابلیت را «سازگاری لهجه» یا Accent Consistency گذاشته است.
آپلود فایل در بین مکالمه
شما میتوانید دادههای ساختاریافته را در لحظه به مکالمه اضافه کنید تا مدل Gemini 3.8 Live آن را با صدای زنده ادغام کند.
نتایج بنچمارک مدلهای Live و Live Extended Thinking
مدل Gemini 3.8 Live Extended Thinking در تمام معیارهای کیفی و قابلیتهای عاملیتمحور (Agentic) که گوگل منتشر کرده پیشتاز است؛ هرچند برتری آن نسبت به مدل «GPT-Live-1 Astra» از شرکت OpenAI کمتر است.
در مقابل، مدل پایه 3.8 Live از نظر هزینه با اختلاف زیادی برنده است؛ اما در انجام وظایف عاملیتمحور عملکرد ضعیفتری دارد.
تکمیل فعالانه وظیفه توسط عاملهای هوشمند
- Gemini 3.8 Live Extended Thinking: 68.6%
- GPT-Live-1 Astra: 67.9%
- Grok Voice Think Fast 2.0: 56.5%
- Gemini 3.1 Flash Live: 37.7%
- Gemini 3.8 Live (base version): 30.1%
کیفیت مکالمه و استدلال
- Gemini 3.8 Live Extended Thinking: 82.6
- GPT-Live-1 Astra: 81.5
- Grok Voice Think Fast 2.0: 81.3
- Gemini 3.8 Live (base version): 76.0
- Gemini 3.1 Flash Live: 71.5
جدول مقایسه کاربرد مدلهای Gemini 3.8 Live
| کاربرد | مدل منتخب | دلیل |
| اولویتبندی خدمات مشتریجستوجوی صوتیتمرین زبان | Gemini 3.8 Live | نوبتگیری فوری بیش از عمق اهمیت دارد و نوبت هر کاربر یک پاسخ دریافت میکند. |
| کنترل دستگاه هوشمندخواندن مقادیر حسگر | Gemini 3.8 Live | ابزارها در میلیثانیه ورودی را گرفته و پردازش میکنند. |
| پشتیبانی فنی در بررسی لاگهاکدهای خطا و پیکربندی | Extended Thinking | تشخیص چند مرحلهای نیاز به استدلال پسزمینه بین مکالمهها دارد. |
| سیستمهای آژانس مسافرتی و رزرواسیون که بهطور موازی از پایگاه داده شرکتهای هواپیمایی و هتلها استعلام میگیرند. | Extended Thinking | تماسهای موازی غیرهمزمان با اعلام آخرین وضعیت کار |
| تدریس خصوصی دروس STEM و برنامهنویسی | Extended Thinking | این مدل پیش از ارائه توضیحات، فرمولها را راستیآزمایی یا کد را عیبیابی میکند. |
مدل ویدیوساز جدید گوگل: Gemini Omni 1.1 Flash
گوگل در ۲۷ آگوست، مدل چندوجهی یکپارچه جدیدی را معرفی کرد که معرفی آن با قابلیتهای ویدیوسازیاش شروع شد. بنابراین میتوانیم این ابزار را با Veo دوست بدانیم؛ اما هرکدام امکانات و ابعاد خاص خودشان را دارند. گوگل ویژگیهای این مدل را در ۳ ویژگی برجسته خلاصه کرد:
«قابلیت گسترش صحنه به ۴۰ ثانیه، کنترل اولین و آخرین فریم و ارتقای کیفیت به 4K.»
دسترسی به هوش مصنوعی Gemini Omni 1.1 Flash
این مدل فعلا فقط در دسترس توسعهدهندگان است که میتوانند از طریق Gemini API در Google AI Studio و پلتفرم Gemini Enterprise Agent گوگل از آن استفاده کنند.
ویژگیهای Gemini Omni 1.1 Flash (ببینید)
این مدل به چند ویژگی مهم در ساخت ویدیو مجهز شده است که در ادامه آنها را معرفی و نشان میدهیم.
گسترش صحنه در لوکیشنهای مختلف
اینکه بتوانیم ویدیوی موجود را اصلاح کنیم و زمان آن را طولانی کنیم یک بحث است؛ اینکه بتوانیم شخصیتها و جزئیات صحنه را حفظ کنیم بحثی دیگر. مدل Gemini Omni 1.1 Flash هردو این کارها را بدون پرامپتنویسی پیچیده یا عجیبوغریب انجام میدهد.
در صفحه رسمی معرفی این مدل، ۴ ویدیو قرار گرفته که خودِ گوگل در توصیف آنها میگوید:
«هوش مصنوعی Gemini Omni 1.1 Flash تا ۱۰ ثانیه اول از ویدیو را بهعنوان زمینه (Context) میبیند و تحلیل میکند؛ جهشی قابلتوجه نسبت به مدلهای قبلی که تنها به ثانیه آخر اکتفا میکردند و کل ویدیو را براساس آن ادامه میدادند.
نتیجه این پیشرفت، بهبود ثبات بصری و حفظ انسجام روایی است که به شما امکان میدهد داستانهای طولانیتری بسازید یا مسیرهای خلاقانه جدیدی را در پیش بگیرید.»
سه ویدیو زیر را ببینید تا این پیشرفت را بهتر درک کنید.
ویدیو اول با پرامپتهای زیر:
| Prompt 1: Camera slightly pans and we now see she is talking to a man with curly hair, we see man’s back, he says “I see it too” dramatic music score |
| Prompt 2: Camera slowly pulls out, forgotten dusty catacombs, dramatic music score. |
| Prompt 3: Camera slowly pulls out, a vast library where shelves and books float weightlessly in a dusty void, dramatic music score. |
ویدیو دوم با پرامپتهای زیر:
| Prompt 1: Continue the video. Execute a cinematic optical dolly-zoom shot. The camera dollies forward while simultaneously zooming out, keeping the character’s frozen shocked face locked at the exact same size. The long corridor of stone pillars in the background dramatically stretches and deepens with intense optical perspective distortion. Clean architecture, continuous unbroken shot. |
| Prompt 2: Continue the video. The camera executes a fast mechanical snap-zoom directly into the character’s wide eyes. Stylized cinematic camera control. |
| Prompt 3: Continue the video. Time completely freezes into a static moment: the character, their windblown coat. The camera performs a smooth, high-speed 360-degree orbital rotation around the frozen character, showcasing dramatic 3D depth and parallax across the colonnade. Flawless continuity. |
ویدیو سوم با پرامپتهای زیر:
| Prompt 1: The looks directly at the camera and talks about what the final chapter will end with! |
| Prompt 2: He then stands up walks around the desk to the camera and says “what would you choose?” |
تعیین فریمهای شروع و پایان
با تعیین فریمهای شروع و پایان یک صحنه، میتوانید ویدیو را بین صحنهها و جزئیات، بدون تغییر شخصیتها و دیگر پارامترها جابهجا کنید و همزمان حرکات دوربین را کنترل کنید. جالب است بدانید که هوش مصنوعی Gemini Omni 1.1 یک ویدیو پیوسته بین دو فریم کلیدی (Keyframe) ایجاد میکند.
از این رو، میتوانیم بگوییم که Gemini Omni 1.1 Flash هوش مصنوعی ایدهآل برای جابهجایی حرفهای حرکت دوربین، تغییر زوم یا کلیپهای تکرارشونده (Loop) است.
ساخت پیشنمایش ویدیو با کیفیت 360p (ببینید)
Gemini Omni 1.1 Flash به شما اجازه میدهد قبل از ساخت ویدیو نهایی، یک پیشنمایش با کیفیت 360p از آن بسازید و خروجی پرامپتتان را ببینید. این کار تا ۶۰ درصد سریعتر و با هزینهای معادل یکسوم کیفیت 720p انجام میشود.
گوگل میگوید این قابلیت برای نمونهسازی لحظهای، اصلاح استوریبرد و رندرینگ سریع لحاظ شده است.
پرامپتهای ساخت پیشنمایش با Gemini Omni 1.1 Flash
| Prompt 1: Fish swimming, tracking shot |
| Prompt 2: A little chipmunk darting out of the woods from the left side of the screen and sniffing the air inquisitively before darting out of frame on the right side |
| Prompt 3: Cinematic macro close-up of vibrant golden-orange Japanese maple leaves on a delicate branch, gently rustling and swaying in a soft, rhythmic autumn breeze. Sunlight filters through the translucent foliage, creating a warm, glowing effect. Shallow depth of field, dreamy bokeh background, hyper-detailed textures, photorealistic, 4k. |
امکان آپلود ویدیو مرجع
هوش مصنوعی Gemini Omni چندوجهی است؛ یعنی میتوانید متن، تصویر و ویدیو را به آن بدهید. بنابراین هنگام ساخت صحنه، مجاز هستید که تا سه ثانیه از ویدیو را برش دهید و آپلود کنید. در این حالت، ساخت ویدیو براساس زمینه بصری و ثبات شخصیت در ویدیو مرجع انجام میشود.
جدول مشخصات فنی مدل ویدیوساز Omni 1.1 Flash
| قابلیت | جزئیات |
| محدودیت توکن | ۱۳۱٬۰۷۲ |
| حداکثر توکن خروجی | ۵۷٬۹۲۰ |
| تفکر عمیق (Thinking) | ✅ |
| شمارشگر توکن | ✅ |
| تولید صدای ویدیو | مکالمه، موزیک، افکت صوتی |
| امکان ویرایش ویدیو | ✅ |
| محدودیت آپلود عکس | ۱۰ عکس در هر پرامپت |
| حداکثر حجم عکس آپلودشده | ۲۰ مگابایت |
| فرمت تصاویر پشتیبانیشده | png، jpeg، webp، heic، heif |
| محدودیت زمانی در آپلود ویدیو | ۱۰ ثانیه |
| محدودیت تعداد ویدیوها در هر آپلود | ۳ ویدیو در هر پرامپت |
| نسبتهای تصویری پشتیبانیشده | 16:9 – 9:16 |
| رزولوشنهای پشتیبانیشده | 360p – 720p – 1080p – 4k |
| فرمتهای ویدیویی پشتیبانیشده | x-flv – Quicktime – mpeg – mpegs – mpg – mp4 – webm – wmv – 3gpp |
Gemini 3.8 Flash گسترده شد و پیشرفت کرد
در یک جمله: گوگل با معرفی Gemini 3.8 Flash، سعی کرد نشان دهد که آزمایشگاه DeepMind آن در تلاش است تا فاصله میان مدلهای سریع و مدلهای قدرتمند را کم کند. بنابراین سرعت و هزینه مناسب خانواده Flash را حفظ میکند و درعینحال قابلیتهای کدنویسی پیچیده، استدلال چندمرحلهای و اجرای عاملهای خودکار با توان بیشتر را به مدلهایش اضافه میکند.
نسخه قبلی: Gemini 3 Pro (محتوای بایگانی)
در ۲۴ ساعت گذشته، گوگل با معرفی Gemini 3 Pro نهفقط یک مدل جدید، بلکه یک «نقطه عطف» در مسیر رسیدن به هوش عمومی مصنوعی (AGI) را رونمایی کرد؛ نقطهای که بسیاری از متخصصان معتقدند میتواند موازنه رقابت را بار دیگر به سود گوگل تغییر دهد. اگر تا دیروز بحث بر سر این بود که کدام شرکت «بهترین مدل» را دارد، امروز مسئله این است که چه کسی میتواند سرعت پیشرفت گوگل را جبران کند.
این نسخه تازه صرفاً یک بهروزرسانی تدریجی نیست؛ ترکیبی است از پیشپردازش عظیم، معماری بزرگمقیاس، ارتقای جدی در استدلال چندمرحلهای، فهم چندرسانهای، و عاملهای خودکار که نشان میدهد گوگل عملاً از «بازیِ مدلها» عبور کرده و وارد «بازیِ اکوسیستم جامع هوش مصنوعی» شده است.
گوگل چگونه به این نقطه رسید؟ زیرساخت، نه شعار
نکتهای که در این میان کمتر دیده میشود، قدرت زیرساختی گوگل است. برخلاف بسیاری از شرکتها که وابسته به GPUهای انویدیا هستند، گوگل Gemini 3 را تماماً روی TPUهای نسل جدید خود آموزش داده است؛ همان نقطهای که سوندار پیچای به آن اشاره میکند:
«توانایی ما برای عرضه قابلیتهای پیشرفته، محصول چرخه کامل و یکپارچهی زیرساخت تا مدل و محصول است.»
این یک تفاوت بنیادین است:
شرکتی که زیرساخت، مدل و توزیع جهانی را یکجا در اختیار دارد، میتواند هر نسل را با سرعتی تصاعدی بهبود دهد.
پرش واقعی: وقتی “بنچمارکها” دیگر محدودیت نیستند
در آزمونهایی که معمولاً مرز توانایی مدلها را مشخص میکنند، Gemini 3 عملاً رکوردشکنی کرده است:
- Humanity’s Last Exam — ۳۷.۵٪ بدون ابزار
- GPQA Diamond — حدود ۹۲٪
- MathArena Apex — رکورد ۲۳.۴٪ در سختترین مسائل ریاضی
- MMMU-Pro و Video-MMMU — بهترین عملکرد در درک بصری و ویدیویی
- SimpleBench مستقل — جهشی ۱۴ واحد درصدی نسبت به Gemini 2.5
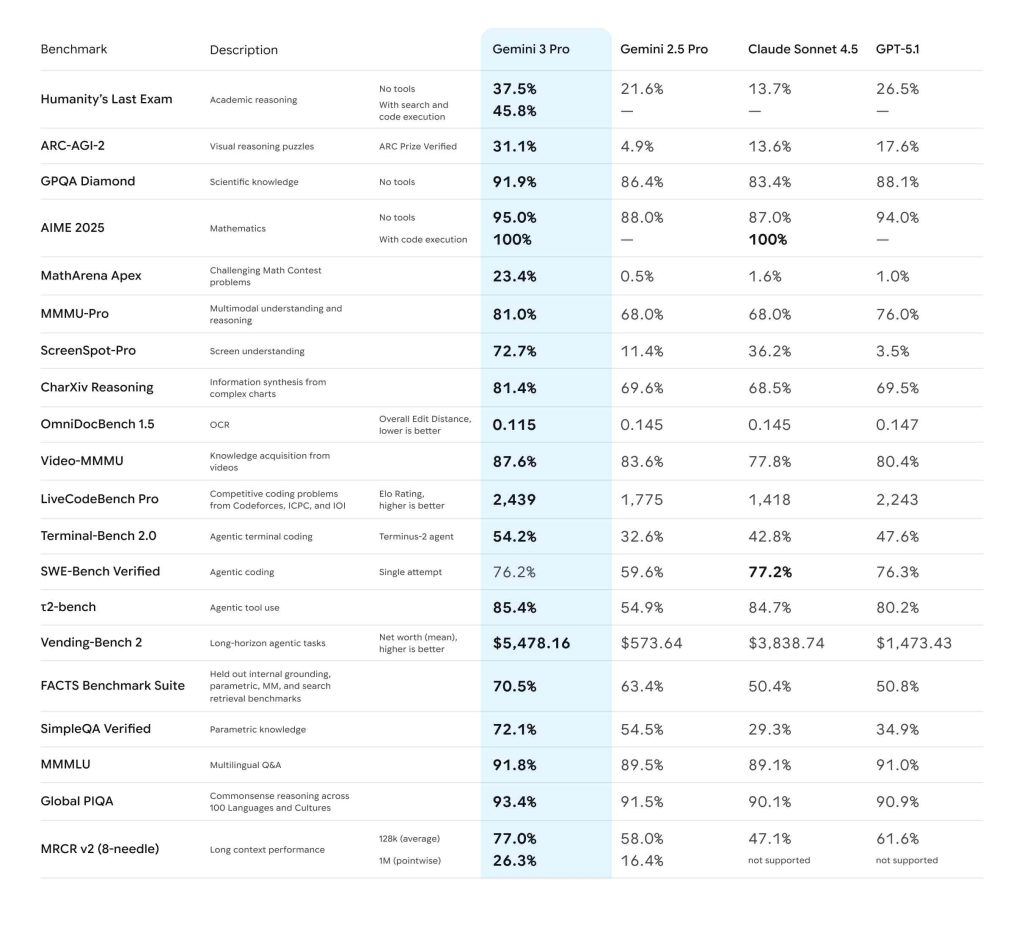
اما نکته مهمتر این است که افزایشها تصادفی نیستند. وقتی مدلی تنها با افزودن داده یا ترفندهای RLHF رشد میکند، معمولاً تنها در چند حوزه خاص بهتر میشود. اما Gemini 3 در طیف گستردهای از شاخصها رشد کرده است؛ نشانهای کلاسیک از اینکه گوگل مقیاس پیشتمرین (Pre-training Scale) را بهطور جدی بالا برده است.
برآوردها از ۱۰ تریلیون پارامتر غیرفعال-فعال حکایت میکنند؛ اندازهای که تنها با زیرساخت اختصاصی و بودجهای در قامت گوگل قابل مدیریت است.
Deep Think: نشانهای از تبدیل LLMها به «متفکران چندمسیره»
در حالت Gemini 3 Deep Think—که هنوز عمومی نشده—مدل همان سؤال را چندبار و در مسیرهای فکری متفاوت بررسی میکند. نتیجه؟ پیشرفت چشمگیری در:
- حل مسائل کاملاً جدید (ARC-AGI-2)
- استدلال چندمرحلهای
- کاهش خطاهای ناشی از “اولین حدس”
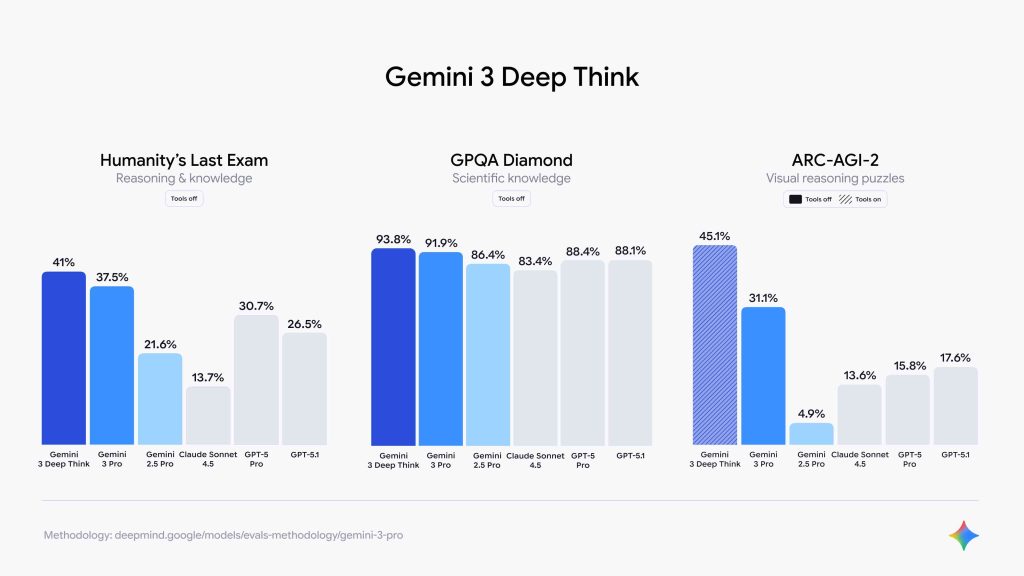
این دقیقاً همان رفتاری است که در پژوهشهای سالهای اخیر بهعنوان «سنگبنای گذار به AGI» از آن یاد شده است:
توانایی مدل برای بازاندیشی، نه صرفاً بازگویی.
عاملهای خودکار و Google Antigravity: از ابزار به همکار هوشمند
یکی از تحولات برجسته Gemini 3، تمرکز جدی بر عاملهای خودکار است. پیش از این، مدلها بیشتر به عنوان ابزار کمکی عمل میکردند: شما سؤال میکردید، پاسخ میدادند، و شما نتیجه را تحلیل میکردید. اما با Google Antigravity، روند کاملاً تغییر کرده است:
- مدل میتواند بهطور مستقل یک وظیفه پیچیده را از ابتدا تا انتها اجرا کند.
- عاملها دسترسی مستقیم به ویرایشگر، ترمینال و مرورگر دارند و میتوانند کد را اجرا، اعتبارسنجی و اصلاح کنند.
- این سیستم برای توسعهدهندگان مانند یک همکار واقعی است که خودش یاد میگیرد، آزمون میکند و بازخورد میگیرد، بدون نیاز به مداخله مکرر انسان.
نمونهای عملی: ساخت یک اپلیکیشن پرواز. عامل Gemini 3 با استفاده از دادههای لحظهای، برنامهریزی، کدنویسی و اعتبارسنجی خودکار انجام میدهد. این یعنی سطح جدیدی از اتوماسیون هوشمند توسعه نرمافزار که تا همین اواخر تنها در تخیل محققان بود.
توانایی یادگیری، ساخت و برنامهریزی؛ فراتر از متن و تصویر
Gemini 3 تنها محدود به پردازش متن و تصویر نیست. قابلیتهای چندرسانهای و زمینهسنجی گسترده آن شامل:
- تحلیل و تبدیل اطلاعات پیچیده (مقالات علمی، ویدئوهای آموزشی طولانی) به راهنماهای تعاملی، فلشکارتها و کدهای آموزشی.
- یادگیری شخصیسازی شده؛ مثلاً تحلیل مسابقات ورزشی یا آموزش دستور پخت خانوادگی به شکل کتابچه تعاملی.
- برنامهریزی بلندمدت؛ مدیریت جریان کاری چندمرحلهای با پایداری قابل توجه، حتی در شبیهسازیهایی مثل مدیریت یک کسبوکار فروشگاهی (Vending-Bench 2).
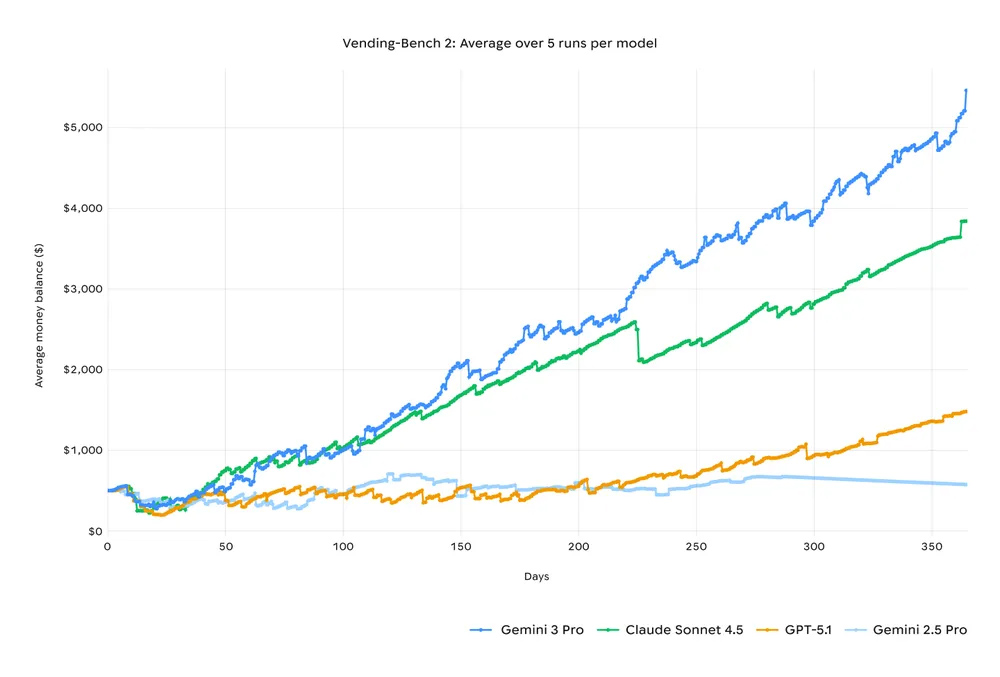
این ویژگیها نشان میدهد Gemini 3 در مسیر تبدیل شدن به یک دستیار هوشمند واقعی برای زندگی روزمره و کار حرفهای است.
امنیت و استفاده مسئولانه؛ کاهش توهم هوش مصنوعی
گوگل با آگاهی از انتقادات و ریسکها، Gemini 3 را با گستردهترین ارزیابیهای امنیتی خود تاکنون عرضه کرده است:
- کاهش تمایل به چاپلوسی یا پاسخهای غیرصادقانه
- مقاومتر در برابر Prompt Injection
- بهبود حفاظت در برابر سوءاستفادههای سایبری
به گفته تیم توسعه، Gemini 3 حتی علائمی از خودآگاهی محدود در محیطهای آزمایشی نشان میدهد—یعنی میتواند تشخیص دهد که تحت آزمایش است و گاهی رفتار خود را تنظیم کند. البته هنوز با هوش انسانی واقعی فاصله دارد، اما این گام مهمی به سمت هوش عام مصنوعی محسوب میشود.
تحلیل نهایی: Gemini 3؛ آیا گوگل از دیگران جلو افتاده است؟
با توجه به دادههای موجود:
- Gemini 3 Pro در بیش از ۲۰ بنچمارک مختلف، رکوردشکنی کرده است.
- در زمینههای استدلال، ریاضیات، چندرسانهای و برنامهنویسی پیشرفت قابل توجهی دارد.
- زیرساختهای گوگل امکان مقیاسپذیری بینظیر و ارائه سرویس به میلیاردها کاربر را فراهم کرده است.
- با Deep Think و Antigravity، شاهد حرکت از مدل به عامل خودکار و متفکر هستیم.
با این اوصاف، به نظر میرسد Gemini 3 نه تنها یک بهروزرسانی تکنیکی، بلکه آغاز یک فصل جدید در رقابت جهانی هوش مصنوعی است؛ فصلی که دیگر بازی بر سر تعداد پارامتر یا سرعت محاسبه نیست، بلکه کیفیت استدلال، توانایی یادگیری مستقل و سازگاری با محیطهای پیچیده است.
اگر بخواهیم جمعبندی کوتاه داشته باشیم: Gemini 3 نشان میدهد که هوش مصنوعی میتواند به تدریج به «همکار واقعی انسان» تبدیل شود و گوگل فعلاً در مسیر رسیدن به این هدف جلوتر از رقباست. اما همانطور که برخی متخصصان پیشبینی میکنند، هوش عمومی واقعی هنوز دستیافتنی نیست و نیاز به یک یا دو پیشرفت بنیادی دیگر دارد.
منبع: https://blog.google/products/gemini/gemini-3/#plan-anything
 رضا حاتمی
رضا حاتمی
 نگین فاتحی
 سارا ارجمند
بهترین جایگزین چت جی پی تی در ایران؛ مقایسه گزینههای رایگان ۲۰۲۶
آموزش ۰ تا ۱۰۰ استفاده از سرویسهای تحت وب هوش مصنوعی ویرا